Ranking rachunków firmowych: konta-dla-firm.pl
Poprzednia część serii: Jak zbudowałem lekką porównywarkę kont firmowych
W poprzednim wpisie pisałem o tym, jak zbudowany jest sam serwis konta-dla-firm.pl — lekki frontend, Cloudflare Workers, zero zbędnego balastu. To był jednak tylko wierzchołek. Zanim ranking pokaże aktualne dane, ktoś (a właściwie coś) musi je najpierw zebrać. Jeśli bank zmieni ofertę, dobrze byłoby wiedzieć o tym, zanim zauważy to ktokolwiek inny. I to jest dokładnie ten kawałek, którego wcześniej nie pokazywałem.
Problem, od którego to się zaczęło
Banki zmieniają oferty bez ostrzeżenia. Oprocentowanie, premie, warunki promocji, terminy — wszystko potrafi się zmienić z dnia na dzień, bez komunikatu. Jeśli chcesz prowadzić rzetelny ranking, a nie kopiować dane raz na jakiś czas, musisz wiedzieć, kiedy coś się zmieniło — najlepiej zanim zauważy to ktokolwiek inny.
Wyglądało na proste zadanie do zautomatyzowania. Jak zwykle w takich przypadkach, dopiero po drodze okazało się, ile jest tam pułapek.
Krok pierwszy: obserwacja źródeł
System codziennie odwiedza strony z ofertami kont firmowych największych banków działających w Polsce. Same instytucje to nie tajemnica — nie pokazuję za to dokładnej struktury linków, po których system je odnajduje, bo to już szczegół techniczny, a nie informacja o rynku.
Pierwszy plan był piękny w swojej prostocie: „przecież wystarczy odpytać linki curlem, zapisać HTML-a i porównywać tekst”. Żadnej przeglądarki, żadnego RAM-u, jeden request i po sprawie. Spodziewałem się, że to nie będzie takie proste, ale postanowiłem spróbować.
Curl regularnie dostawał w twarz. Część ofert renderuje się dopiero w przeglądarce, po JavaScripcie — curl zwracał więc pusty szkielet strony, nieświadomy, że powinien „poczekać, aż coś się wydarzy”. A tam, gdzie akurat dostawał treść, i tak często był banowany przy pierwszym zapytaniu — bo strona z miejsca rozpoznawała, że to nie jest prawdziwa przeglądarka. Zero danych, zero informacji, sama odmowa.
Wniosek: gonienie za lekkością na tym etapie to droga donikąd. Zamiast tego — Playwright: headless przeglądarka sterowana skryptem w Pythonie, cyklicznie odpalana na małym VPS-ie. Cięższe rozwiązanie, więcej ruchomych części, ale przynajmniej dostaję to, co faktycznie widzi człowiek, a nie pustkę albo grzeczną odmowę.
Przy okazji ukłon w stronę Tomka Zielińskiego — byłem na pierwszej edycji jego kursu o scrapowaniu i część tamtej wiedzy przydała mi się właśnie tutaj, przy stronach, które nie chcą współpracować.
Dalej było już tylko więcej detali. Jeden z banków ma formularz typu SPA, który potrzebuje kilku sekund, zanim w ogóle pokaże tekst oferty — za krótkie oczekiwanie i system zgrywał pustą stronę, uznając ją potem błędnie za „zmienioną”. A do tego jeszcze banery cookies: każda strona chowa je pod inną nazwą klasy, innym tekstem, innym zestawem przycisków. Zadziałało połączenie dwóch rzeczy — blokowanie znanych domen dostawców zgód, zanim zdążą się załadować, oraz rozpoznawanie elementów po charakterystycznych nazwach i frazach i ich usuwanie z widoku strony.
COOKIE_KEYWORDS = [
    "ta strona używa cookies",
    "akceptuj wszystkie pliki cookie",
    "wykorzystujemy na naszych stronach pliki cookies",
]

COOKIE_ELEMENT_NAMES = [
    "cookiebanner", "cookieconsent", "cookiebot",
    "usercentrics-cmp-ui", "onetrust-banner-sdk",
    "cc-window", "cc-banner", "cookie-notice",
    "eu-cookie", "gdpr-cookie-notice",
]

# blokada domen CMP jeszcze zanim strona zdąży je załadować
BLOCKED_CMP_DOMAINS = [
    "cookiebot.com", "onetrust.com", "usercentrics.eu",
    "cookielaw.org", "consensu.org",
]
Pierwsza wersja tego mechanizmu była zbyt agresywna i potrafiła przy okazji wyciąć fragment prawdziwej oferty. Kilka razy „naprawiłem” jeden bank, a popsułem drugi.
Krok drugi: mały VPS, duże ambicje
Przeglądarka odwiedzająca kilkadziesiąt stron i czekająca na ich renderowanie potrafi być zaskakująco żarłoczna, jeśli chodzi o pamięć. A serwer, na którym to wszystko chodzi, to nie jest żadna maszyna do zadań specjalnych — jeden z tańszych, małych VPS-ów, z bardzo ograniczonym RAM-em.
Domyślne ustawienia przeglądarki są zaprojektowane z myślą o desktopie, nie o małym serwerze uruchamiającym ją dziesiątki razy dziennie w tle. Trzeba było świadomie wyłączyć wszystko, czego przeglądarka i tak by nie użyła — GPU, procesy w tle, powiadomienia, telemetrię.
browser = playwright.chromium.launch(
    headless=True,
    args=[
        "--disable-gpu",
        "--disable-extensions",
        "--disable-background-networking",
        "--disable-background-timer-throttling",
        "--disable-renderer-backgrounding",
        "--no-first-run",
        "--mute-audio",
        "--no-sandbox",
    ]
)
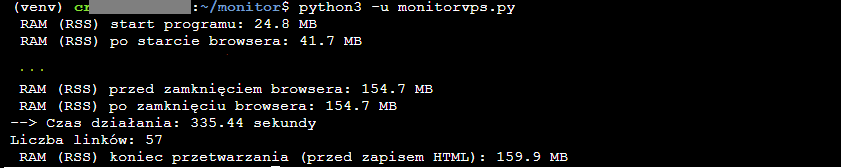
Dorzuciłem też prosty nawyk: logowanie zużycia RAM w kluczowych momentach skryptu, żeby widzieć, na którym etapie i przy której stronie pamięć nagle skacze. Co się później okazało, optymalizacja była nadzwyczaj udana. Nie spodziewałem się, że zejdę do takiego wyniku.
Krok trzeci: porównanie dzień do dnia
Sama treść oferty niewiele daje, jeśli nie masz z czym jej porównać. Dlatego każdego dnia zapisywana jest „migawka” wszystkich ofert i zestawiana z tym, co system zebrał dzień wcześniej — klasyczny diff, dokładnie taki, jakiego programiści używają do porównywania kodu, tylko zastosowany do ofert bankowych.
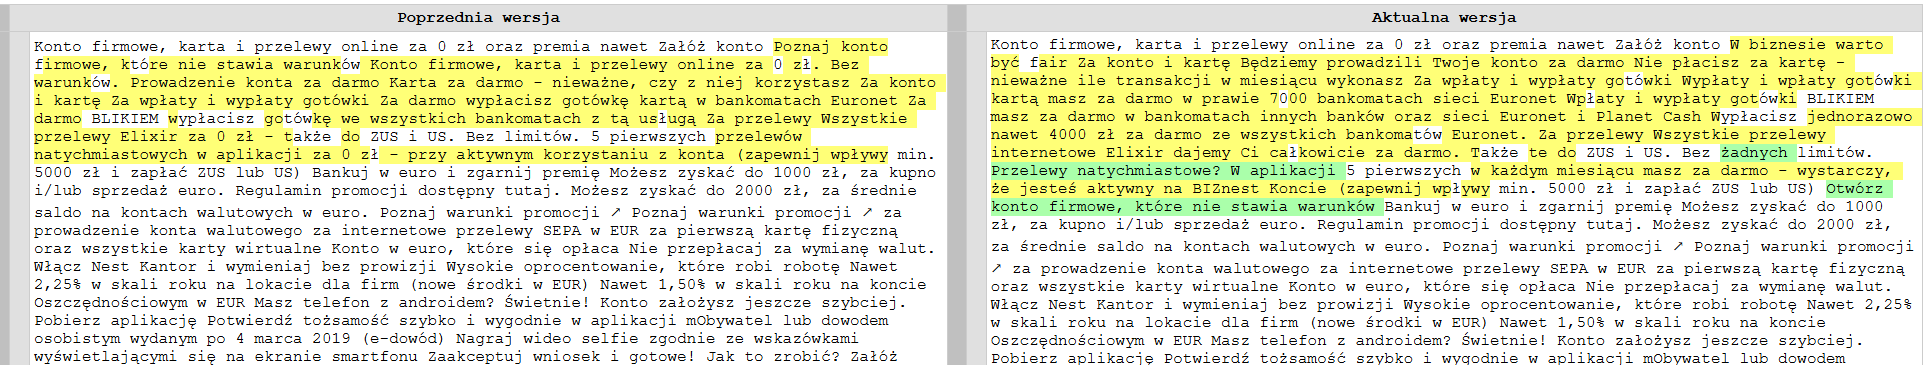
Diff mówi tylko tyle: coś się zmieniło. Czy to realna zmiana warunków, czy zwykły szum — to już inna sprawa, i tu robi się ciekawiej.
Co dzieje się ze zmianą dalej
Łatwo założyć, że wszystko płynie jedną linią: strona → dane → diff → AI → ranking. W praktyce po wykryciu zmiany dane rozjeżdżają się na dwa niezależne kierunki — a to, co widać poniżej, to tylko ten jeden strumień danych, obok którego równolegle płynie jeszcze drugi, z zewnętrznego API.
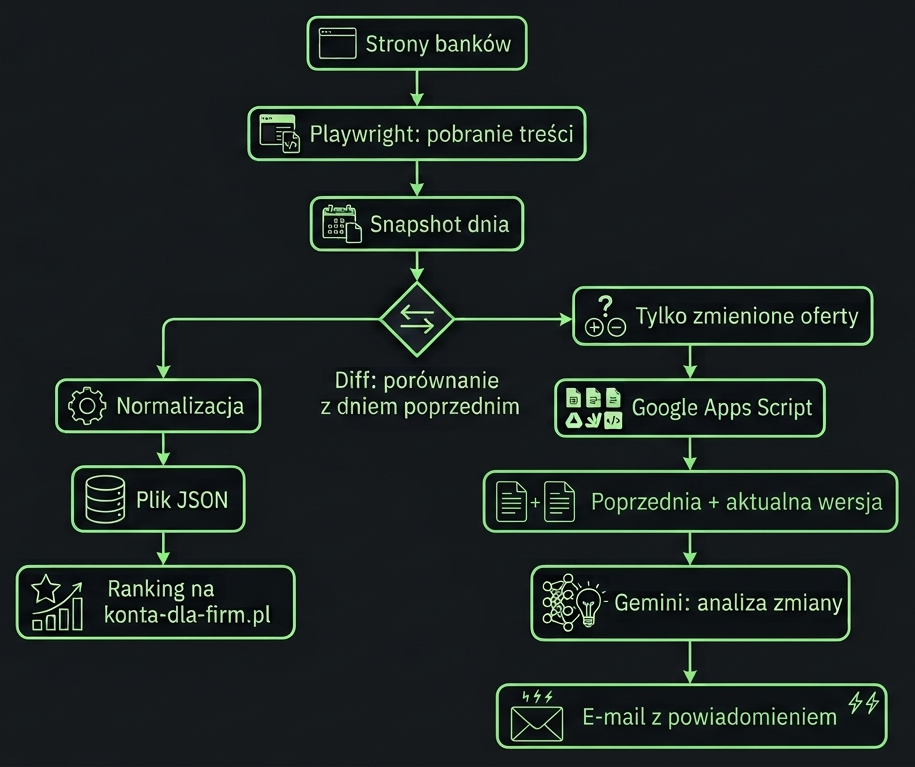
Pierwszy kierunek to ten właściwy, zasilający porównywarkę: każda świeżo pobrana oferta — niezależnie od tego, czy diff coś w niej wykryje — jest normalizowana i zapisywana do JSON-a. Warto dodać: ranking na konta-dla-firm.pl korzysta z tego JSON-a jako jednego z dwóch źródeł — obok niego działa jeszcze zewnętrzne API, a przy rozbieżnościach pierwszeństwo mają dane z monitoringu. Dzieje się to równolegle do porównywania, nie jako jego dalszy etap. To fundament projektu, o którym pisałem przy okazji poprzedniego wpisu o cache’owaniu danych.
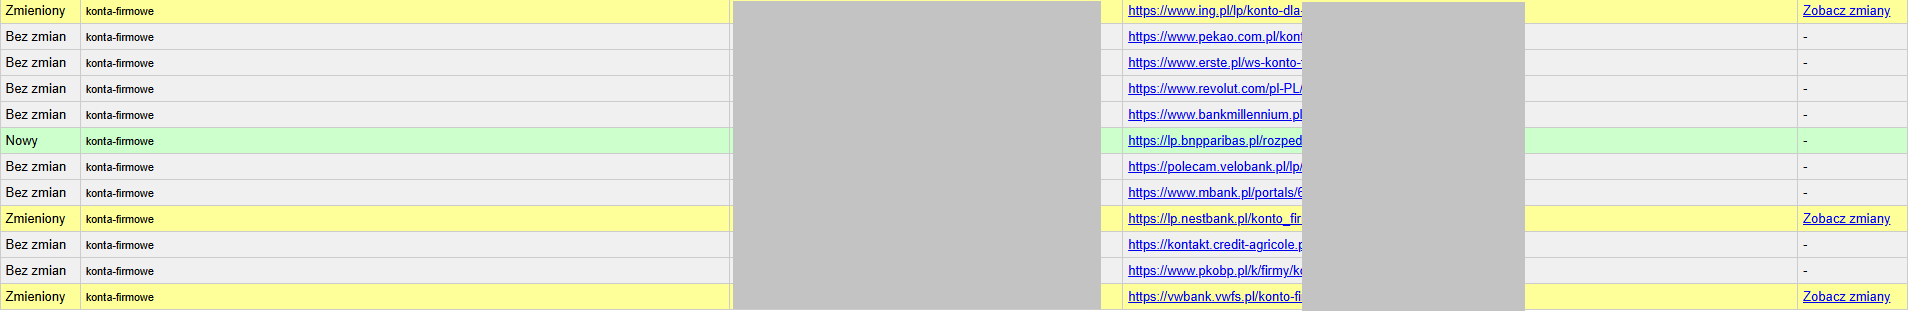
Drugi kierunek to już nie ranking, tylko osobny mechanizm monitoringu — miał po prostu oszczędzić mi czasu na ręczne sprawdzanie „co się dziś zmieniło”. Trafiają tam wyłącznie oferty, które diff oznaczył jako zmienione. Zbiorcza tabela ląduje na małym, tanim hostingu — wygodny podgląd bez logowania się nigdzie indziej.
Dodatkowa warstwa: druga para oczu
Ten mechanizm monitoringu — Google Apps Script podpięty pod arkusz Google — regularnie sprawdza, czy pojawiły się nowe, zmienione oferty, pobiera dla nich poprzednią i aktualną wersję treści i zapisuje w arkuszu. Model AI nie ogląda więc całego ruchu z crawlera — dostaje tylko te przypadki, które diff już wyselekcjonował.
Pobrane treści do arkusza trafiają dalej do Google AI Studio, gdzie każdą zmianę sprawdza model Gemini (dokładnie const model = 'gemini-3.5-flash-lite' - ponieważ jest wystarczająco mądry do tego zadania, i ma dużo darmowych zapytań). Zamiast czytać „przed i po” ręcznie, model dostaje obie wersje razem z jasnymi zasadami: co ma priorytet (oprocentowanie, premie, warunki, terminy, opłaty), a co ma zignorować jako szum (linki, przeformułowania, stopki, literówki).
Mój prompt wygląda bardzo podobnie do tego poniżej:
Jesteś precyzyjnym analitykiem produktów bankowych i finansowych.
Twoim zadaniem jest porównanie dwóch wersji strony oferty (poprzedniej
i aktualnej) i sporządzenie zwięzłego, rzeczowego podsumowania zmian
biznesowych.

DANE WEJŚCIOWE:
- ID Formularza: {id}
- Kategorie produktu: {kategorie}
- URL Produktu: {url}
- Poprzednia wersja: """{poprzednia}"""
- Aktualna wersja: """{aktualna}"""

ZASADY ANALIZY:
1. IDENTYFIKACJA: określ bank/instytucję oraz nazwę produktu na
   podstawie kategorii i tekstu oferty.
2. KLUCZOWE PARAMETRY BIZNESOWE (priorytet):
   - oprocentowanie / marża / prowizja (zawsze: stara wartość ->
     nowa wartość),
   - czy rachunek jest darmowy i czy ma warunki zwolnienia z opłaty,
   - premie, bonusy, cashback, nagrody,
   - terminy ważności promocji,
   - warunki aktywności wymagane do premii,
   - opłaty za prowadzenie rachunku, kartę lub przelewy.
3. FILTROWANIE SZUMU:
   - zmiany w linkach, politykach cookies, headers i literówki
     traktuj jako "zmiany kosmetyczne / techniczne",
   - jeśli treść jest praktycznie identyczna i nie dotyczy warunków konta,
     określ to jako "drobne zmiany prezentacyjne".

FORMAT WYJŚCIOWY (maks. 2-3 zdania, bez markdown):
Wariant A (gdy są realne zmiany w ofercie):
W formularzu ${id} ({BANK} – {Nazwa produktu}) zmieniono: {zwięzła lista konkretnych zmian z liczbami/datami}.
Wariant B (brak zmian merytorycznych):
W formularzu ${id} ({BANK} – {Nazwa produktu}) zaszły jedynie zmiany ... (brak zmian w parametrach oferty).
Wariant C (gdy oferta nie działa):
W formularzu ${id} ({BANK} – {Nazwa produktu}) strona oferty jest nieaktywna lub niedostępna.
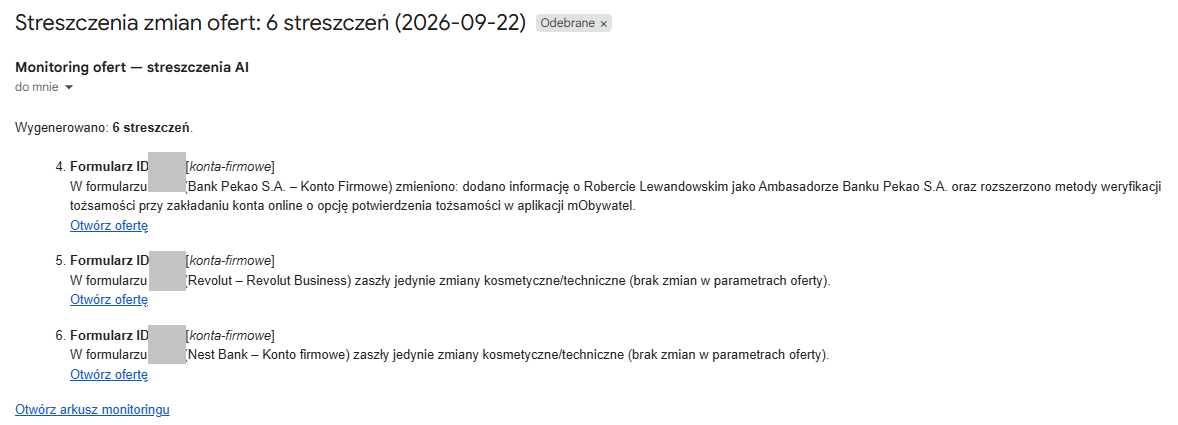
Pierwsze podejścia miały tendencję do „znajdywania” zmian tam, gdzie ich nie było — po prostu inaczej sformułowane zdanie. Dopiero jasno opisane priorytety i szum do zignorowania sprawiły, że podsumowania stały się na tyle wiarygodne, żeby na nich polegać. Efekt: krótkie zdanie w stylu „oprocentowanie wzrosło z 4,00% na 4,20%” albo „zmiana wyłącznie techniczna”. Jeśli analiza wykaże realną zmianę, leci e-mail — bez klikania czegokolwiek ręcznie.
Ile to kosztuje
Sam rachunek za infrastrukturę nie jest szczególnie imponujący — mały VPS, hosting pod dane i raporty, arkusz Google i niewielkie zużycie Gemini. Miesięcznie nie są to duże kwoty.
To oczywiście tylko część prawdy. Najdroższy element tego systemu nie ma żadnej pozycji na fakturze — to czas poświęcony na jego zbudowanie, testowanie i późniejsze utrzymanie. Każdy problem z renderowaniem strony, pamięcią przeglądarki, cookie-bannerem czy zmianą po stronie banku trzeba było najpierw znaleźć, a potem jakoś rozwiązać.
Sam system jest więc tani w utrzymaniu, ale nie był tani w czasie, który trzeba było w niego włożyć. I chyba właśnie to jest ciekawsze niż sama kwota na fakturze.
Zobacz efekt tego systemu
Aktualne oferty kont firmowych, aktualizowane automatycznie co 24 godziny — bez reklam i bez ukrytych promocji.
konta-dla-firm.pl →Dlaczego akurat tak
Mógłbym to postawić na jednej dużej platformie, z jednym dashboardem. Świadomie tego nie zrobiłem. Jeśli mam możliwość zbudować coś własnego, przy okazji zaprojektować cały przepływ daych, to czemu miałbym używać gotowców? Tutaj znam każdy etap — zbieranie, porównywanie, streszczanie, powiadamianie — to osobny, prosty klocek, który robi jedną rzecz i nie musi wiedzieć nic o pozostałych. Jeśli jeden padnie, reszta dalej działa, a naprawa to jedno miejsce, nie grzebanie w całości.
To nie jest kombajn korporacyjny — to zestaw małych, tanich narzędzi, które akurat świetnie się uzupełniają. Ranking na konta-dla-firm.pl zawsze dostaje aktualne dane, niezależnie od warstwy AI opisanej wyżej — ta pracuje obok, równolegle, i pomaga głównie mnie: żebym wiedział, co się zmieniło, zanim zauważy to ktokolwiek inny.
Jeśli coś Cię tu zaciekawiło — dawaj znać w komentarzu, chętnie rozwinę wybrany wątek w kolejnym wpisie.